Membangun AI Tanpa Menguras Air

Ruben Cornelius Siagian, Founder Siagian Global Research Center yang berbasis di Medan, IndonesiaDok. Pribadi
Kecerdasan artifisial (artificial intelligence/AI) semakin ditempatkan sebagai salah satu teknologi strategis bagi masa depan Indonesia. AI diharapkan meningkatkan produktivitas, mempercepat pelayanan publik, memperkuat industri, mengembangkan riset, dan menciptakan sumber pertumbuhan ekonomi baru. Karena itu, pembangunan infrastruktur digital, pusat data, compute cluster, jaringan telekomunikasi, energi, dan talenta AI mulai memperoleh perhatian yang semakin besar. Namun, di tengah optimisme tersebut, terdapat satu pertanyaan yang belum memperoleh perhatian sebanding, yaitu berapa banyak air yang dibutuhkan untuk membuat infrastruktur AI tetap beroperasi?
Pertanyaan menjadi semakin relevan setelah muncul kasus pembangunan pusat data AI di kawasan Jatiluhur, Kabupaten Purwakarta. Pemerintah Provinsi Jawa Barat pada 1 Oktober 2026 mengumumkan penghentian sementara pembangunan proyek tersebut karena dokumen AMDAL dan Persetujuan Bangunan Gedung belum tersedia. Pemerintah daerah juga meminta agar kajian mengenai penggunaan air dari Waduk Jatiluhur dibuka kepada masyarakat serta memastikan kebutuhan pusat data tidak mengganggu pemanfaatan air untuk masyarakat dan pertanian. Proyek direncanakan memiliki kapasitas listrik hingga 640 MW. Kasus ini memperlihatkan bahwa pembangunan pusat data AI bukan semata-mata persoalan teknologi dan investasi. Di belakangnya terdapat persoalan tata ruang, energi, air, lingkungan, dan kepentingan masyarakat yang harus dihitung secara bersamaan.
AI sering terlihat seperti teknologi yang berada “di awan”. Pengguna mengetik pertanyaan melalui komputer atau telepon, kemudian jawaban muncul dalam beberapa detik. Namun, di balik pengalaman digital tersebut terdapat infrastruktur fisik yang sangat besar. Model AI membutuhkan GPU (graphics processing unit) dan CPU (central processing unit) berperforma tinggi yang bekerja secara intensif (Zhang dkk., 2025). Komputasi menghasilkan panas sehingga sistem pendinginan diperlukan agar perangkat tetap beroperasi pada temperatur aman (Chu dkk., 2004). Pada pusat data tertentu, proses pendinginan menggunakan air. Sehingga terdapat hubungan sederhana yang sering tidak terlihat oleh pengguna, yaitu AI membutuhkan komputasi, komputasi membutuhkan listrik, listrik menghasilkan panas, panas membutuhkan pendinginan, dan pendinginan dapat membutuhkan air.
Persoalannya bahkan lebih kompleks. Listrik yang digunakan pusat data juga dapat memiliki jejak air karena sebagian pembangkit listrik menggunakan air dalam proses produksinya (Siddik dkk., 2021). Adapun produksi semikonduktor dan perangkat keras juga membutuhkan air (Williams dkk., 2002). Sehingga jejak air AI tidak cukup dihitung berdasarkan air yang secara langsung masuk ke gedung pusat data.
Li, Yang, Islam, dan Ren melalui penelitian Making AI Less “Thirsty” menunjukkan pentingnya melihat persoalan tersebut secara menyeluruh (Li dkk., 2025). Dalam studi kasus GPT-3, mereka memperkirakan pelatihan model tersebut di pusat data Microsoft di Amerika Serikat berkaitan dengan konsumsi sekitar 5,4 juta liter air jika konsumsi langsung dan tidak langsung diperhitungkan, dengan sekitar 700.000 liter berasal dari konsumsi air langsung di lokasi. Penelitian tersebut juga memperkirakan bahwa sekitar 500 mL air dapat dikaitkan dengan 10–50 respons GPT-3 berukuran sedang, bergantung pada lokasi dan waktu operasi. Angka ini tentu bukan berarti setiap pertanyaan kepada setiap model AI selalu membutuhkan setengah liter air. Angka tersebut merupakan estimasi yang dipengaruhi berbagai asumsi, lokasi pusat data, teknologi pendinginan, sumber listrik, dan karakteristik beban komputasi. Justru di sinilah pesan penelitian tersebut, bahwa jejak air AI sangat bergantung pada bagaimana, kapan, dan di mana AI dijalankan.
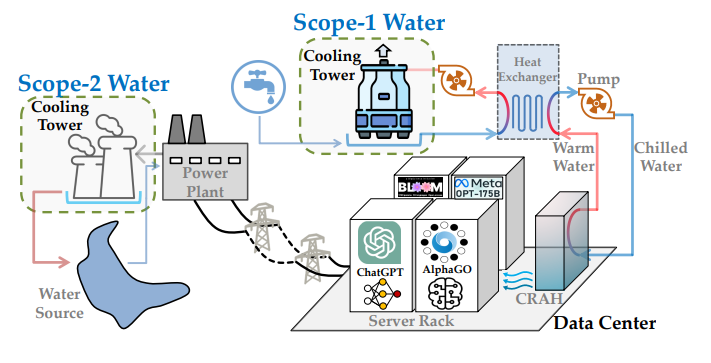
Contoh penggunaan air operasional pusat data (Scope-1 dan Scope-2)
Dapat dilihat pada gambar di atas bahwa pusat data menggunakan air secara operasional dalam dua lingkup, yaitu Scope-1 (pendinginan langsung di lokasi melalui cooling tower) dan Scope-2 (air yang dipakai di pembangkit listrik untuk menghasilkan listrik). Gambar ini diambil dari artikel Making AI Less “Thirsty”: Uncovering and Addressing the Secret Water Footprint of AI Models karya Pengfei Li dkk.
Selama ini pembicaraan mengenai keberlanjutan pusat data lebih banyak berfokus pada carbon footprint. Pendekatan tersebut karena pusat data membutuhkan listrik dalam jumlah besar dan dapat berkontribusi terhadap emisi gas rumah kaca (Siddik dkk., 2021). Namun, hanya melihat karbon dapat menghasilkan gambaran yang tidak lengkap. Sebuah pusat data dapat menggunakan listrik yang relatif rendah karbon tetapi tetap mempunyai kebutuhan air yang tinggi apabila menggunakan sistem pendinginan berbasis evaporasi (Coroamă & Dumbravă, 2026). Sebaliknya, teknologi pendinginan tertentu dapat mengurangi kebutuhan air secara signifikan.
Karena itu, Indonesia membutuhkan perspektif water footprint dalam pembangunan AI. Secara sederhana, konsumsi air untuk pendinginan dapat didekati melalui persamaan dengan sebagai energi yang digunakan perangkat teknologi informasi dan WUE (Water Usage Effectiveness) sebagai konsumsi air per satuan energi. Semakin besar beban komputasi dan semakin tinggi WUE, semakin besar kebutuhan air. Jika analisis diperluas, jejak air AI dapat dipandang sebagai kombinasi konsumsi air langsung di pusat data, konsumsi air tidak langsung dari pembangkitan listrik, serta jejak air dalam rantai pasok perangkat keras.
Penelitian mengenai penggunaan air pada data center workloads juga menunjukkan bahwa konsumsi air dapat berbeda sangat besar bergantung pada efisiensi server, utilisasi, teknologi pendinginan, iklim, sumber listrik, dan karakteristik infrastruktur (Lei dkk., 2025). Artinya, tidak ada satu angka konsumsi air yang dapat diterapkan secara universal kepada semua pusat data AI. Lokasi menjadi variabel ekologis. Pusat data di wilayah dengan kondisi temperatur dan kelembapan tertentu akan menghadapi kebutuhan pendinginan yang berbeda dengan pusat data di wilayah lain.
Karena itu, pembangunan pusat data AI di Indonesia tidak seharusnya hanya ditentukan oleh ketersediaan listrik, konektivitas internet, harga tanah, atau kedekatan dengan pusat ekonomi. Ketersediaan dan kerentanan sumber daya air juga harus menjadi bagian dari keputusan lokasi.
Kasus Jatiluhur memperlihatkan persoalan tersebut. Kapasitas listrik 640 MW memang menunjukkan skala proyek yang besar, tetapi angka tersebut tidak dapat langsung diterjemahkan menjadi konsumsi air. Untuk mengetahui kebutuhan air sebenarnya, diperlukan informasi tentang beban IT aktual, PUE, WUE, jenis teknologi pendinginan, sumber listrik, pola operasi, serta kebutuhan air lainnya. Karena itu, keterbukaan informasi menjadi sangat penting. Masyarakat perlu dapat mengetahui berapa kebutuhan air harian dan tahunan, dari mana air diperoleh, berapa water withdrawal dan water consumption, teknologi pendinginan yang digunakan, bagaimana kebutuhan air berubah pada musim kemarau, serta bagaimana proyek tersebut berinteraksi dengan kebutuhan air masyarakat dan pertanian.
Hal ini karena air tidak tersedia dalam ruang sosial yang kosong. Air yang digunakan industri adalah sumber daya yang pada saat yang sama dibutuhkan oleh rumah tangga, pertanian, industri lain, dan ekosistem. Persoalan menjadi lebih kompleks ketika pusat data ditempatkan di wilayah yang mengalami tekanan air musiman. Karena itu, keberhasilan pembangunan pusat data tidak cukup diukur dari seberapa cepat gedung selesai atau seberapa besar kapasitas GPU yang tersedia. Keberhasilan juga harus diukur dari kemampuan proyek tersebut mengelola sumber daya yang menjadi fondasinya.
Indonesia memang memiliki alasan kuat untuk mengembangkan infrastruktur AI. Pemerintah sedang membangun ekosistem AI nasional dan memperkuat infrastruktur digital sebagai bagian dari strategi ekonomi digital. Pertumbuhan pusat data juga dilihat sebagai peluang investasi dan pengembangan ekonomi. Akan tetapi, ekspansi komputasi membawa konsekuensi yang perlu diantisipasi. Lebih banyak GPU berarti kebutuhan listrik yang lebih besar. Lebih banyak listrik untuk komputasi menghasilkan panas yang lebih besar. Panas tersebut membutuhkan sistem pendinginan. Apabila pendinginan bergantung pada air tawar, maka pertumbuhan AI berpotensi meningkatkan tekanan terhadap sumber daya air.
Di sinilah Indonesia menghadapi sebuah paradoks pembangunan. Negara membutuhkan AI untuk meningkatkan efisiensi pengelolaan sumber daya, tetapi infrastruktur AI sendiri membutuhkan sumber daya yang besar. AI dapat digunakan untuk memprediksi kekeringan, mengoptimalkan jaringan listrik, mendeteksi kebocoran air, meningkatkan produktivitas pertanian, dan membantu mitigasi bencana. Namun pada saat yang sama, pusat data AI dapat menjadi konsumen energi dan air dalam jumlah besar. Karena itu, pertanyaannya bukan apakah Indonesia harus memilih antara AI atau lingkungan. Pertanyaannya adalah bagaimana membangun AI yang secara ekologis dapat dipertanggungjawabkan.
Untuk itu, tata kelola AI Indonesia perlu diperluas. Tata kelola AI tidak cukup hanya membahas keamanan data, bias algoritmik, hak cipta, keamanan siber, dan perlindungan pengguna. Infrastruktur fisik yang menopang AI juga harus masuk dalam kerangka environmental governance. Pusat data AI berskala besar seharusnya memiliki kewajiban pelaporan mengenai PUE, WUE, konsumsi listrik, konsumsi air, sumber air, teknologi pendinginan, sumber energi, dan risiko operasional ketika terjadi kekeringan.
AMDAL juga perlu berkembang mengikuti karakter teknologi baru. Untuk pusat data AI berskala besar, kajian lingkungan seharusnya tidak hanya menghitung konstruksi dan limbah, tetapi juga menyusun neraca air yang membandingkan kebutuhan pusat data dengan ketersediaan air dan kebutuhan masyarakat di wilayah tersebut. Izin pembangunan tidak hanya mempertanyakan apakah suatu proyek secara teknis dapat dibangun, tetapi juga apakah kebutuhan sumber dayanya dapat dipenuhi secara berkelanjutan.
Indonesia juga dapat mendorong penggunaan teknologi pendinginan yang lebih hemat air, seperti dry cooling, closed-loop cooling, dan sistem direct-to-chip liquid cooling, sekaligus meningkatkan penggunaan air daur ulang atau air non-potabel apabila secara teknis dan lingkungan memungkinkan. Tujuannya bukan sekadar menciptakan label “data center hijau”, melainkan menghasilkan pusat data dengan intensitas penggunaan air yang terukur dan dapat terus dikurangi.
Yang tidak kalah penting adalah penentuan lokasi berdasarkan water stress. Tidak semua wilayah Indonesia memiliki kondisi hidrologis yang sama. Karena itu, wilayah dengan tekanan air tinggi semestinya memiliki persyaratan yang lebih ketat untuk pembangunan pusat data. Sebaliknya, lokasi dengan kapasitas air yang lebih baik dapat dipertimbangkan dengan tetap memperhatikan ekosistem, masyarakat, dan keberlanjutan jangka panjang. Maka pertanyaan dalam memilih lokasi tidak lagi sekadar “di mana listrik murah?”, tetapi “di mana komputasi dapat beroperasi dengan risiko ekologis yang dapat dikelola?”
Indonesia bahkan mempunyai peluang untuk mengembangkan standar pengukuran yang lebih maju, yaitu menghitung water footprint per AI workload. Konsumsi air dapat dinormalisasi terhadap GPU-hours, jumlah training runs, jumlah inference requests, token, atau ukuran komputasi tertentu. Pendekatan ini memungkinkan efisiensi air dibandingkan secara lebih bermakna antara teknologi dan fasilitas yang berbeda.
Penelitian Indonesia juga dapat mengambil peran. Data NASA POWER, data meteorologi lokal, informasi PUE dan WUE, sumber energi, serta indeks tekanan air dapat digabungkan untuk membangun model konsumsi air pusat data berbasis kondisi iklim Indonesia. Temperatur, kelembapan, dan wet-bulb temperature dapat dianalisis secara temporal untuk mengetahui bagaimana kondisi atmosfer memengaruhi kebutuhan pendinginan. Sehingga Indonesia tidak perlu hanya mengandalkan estimasi dari Amerika Serikat atau negara lain. Kita dapat membangun basis data dan model yang sesuai dengan karakter iklim dan hidrologi Indonesia.
Pembangunan data center AI bukan persoalan memilih investasi atau lingkungan. Keduanya dapat berjalan bersama apabila aturan dibuat sejak awal. Kasus Jatiluhur justru dapat menjadi momentum untuk membangun standar yang lebih baik sebelum ekspansi pusat data AI berlangsung lebih luas.
AI tidak berada di awan. AI berada di gedung-gedung nyata, menggunakan server nyata, membutuhkan listrik nyata, menghasilkan panas nyata, dan dalam desain tertentu membutuhkan air nyata. Karena itu, ketika Indonesia membicarakan masa depan AI, pertanyaannya tidak cukup berhenti pada berapa banyak GPU yang dapat dipasang atau berapa megawatt listrik yang tersedia. Kita juga perlu bertanya; dari mana airnya, berapa banyak yang digunakan, bagaimana kebutuhan tersebut berubah ketika musim kemarau, dan bagaimana memastikan kebutuhan industri tidak mengurangi hak masyarakat terhadap sumber daya air.
Indonesia memiliki kesempatan untuk membangun ekosistem AI yang tidak hanya besar, tetapi juga efisien dan bertanggung jawab. Masa depan AI Indonesia semestinya tidak hanya diukur dari kapasitas komputasi, nilai investasi, dan jumlah pusat data, tetapi juga dari kemampuan mengelola sumber daya alam yang menopangnya. Sebab kecerdasan sebuah negara bukan hanya terlihat dari seberapa besar teknologi yang mampu dibangunnya, melainkan juga dari seberapa bijak negara tersebut memastikan teknologi itu dapat berkembang tanpa mengorbankan lingkungan dan kebutuhan generasi mendatang.
Referensi
Chu, R. C., Simons, R. E., Ellsworth, M. J., Schmidt, R. R., & Cozzolino, V. (2004). Review of cooling technologies for computer products. IEEE Transactions on Device and materials Reliability, 4(4), 568–585.
Coroamă, V. C., & Dumbravă, O. (2026). Circular Economy Synergies and Trade-offs in Data Centres. arXiv preprint arXiv:2608.04571.
Lei, N., Lu, J., Shehabi, A., & Masanet, E. (2025). The water use of data center workloads: A review and assessment of key determinants. Resources, Conservation and Recycling, 219, 108310.
Li, P., Yang, J., Islam, M. A., & Ren, S. (2025). Making ai less’ thirsty’. Communications of the ACM, 68(7), 54–61.
Siddik, M. A. B., Shehabi, A., & Marston, L. (2021). The environmental footprint of data centers in the United States. Environmental Research Letters, 16(6), 064017.
Williams, E. D., Ayres, R. U., & Heller, M. (2002). The 1.7 kilogram microchip: Energy and material use in the production of semiconductor devices. Environmental science & technology, 36(24), 5504–5510.
Zhang, Z.-X., Wen, Y.-B., Lyu, H.-Q., Liu, C., Zhang, R., Li, X.-Q., Wang, C., Du, Z.-D., Guo, Q., & Li, L. (2025). AI computing systems for large language models training. Journal of Computer Science and Technology, 40(1), 6–41.
*) Ruben Cornelius Siagian aktif dalam penelitian di bidang astrofisika, machine learning, dan komputasi fisika, dengan fokus pada analisis data ilmiah, pemodelan numerik, serta penerapan kecerdasan buatan dalam berbagai konteks. Publikasinya mencakup topik lubang hitam, aktivitas matahari, radiasi, hingga aplikasi machine learning untuk klasifikasi dan prediksi, dengan total sitasi sekitar 122 dan h-index 6.